
なぜ「コンテクスト」が「検索」よりも突然大人気になったのでしょうか?
大規模言語モデル (LLM) が「1 回限りの質問応答ツール」から「継続的な対話エージェント」へと進化するにつれて、テクノロジーフォーカスは変化しており、検索は「知識はどこから来るのか」という問題を解決し、コンテキストは「知識をどのように使用するか」という問題を解決します。
2023 年の RAG (検索拡張生成) の普及は、LLM の「外部知識」の欠点を本質的に補います。 しかし、2024年以降、企業の導入で発生した対話健忘症、パーソナライゼーションの欠如、コストの制御喪失が複数回繰り返されたことで、業界は「検索+生成」のプロセスだけでは、複雑なシナリオ(インテリジェントカスタマーサービス、パーソナルバトラー、企業OAアシスタントなど)の継続的な対話ニーズをサポートできないことを認識しています。
LangChainがContext Engineering for Agentsで指摘しているように、「LLMの能力の境界は、もはやパラメータのサイズではなく、コンテキストを管理する能力によって決定されます。」 ユーザーが「最後の好みを記憶する」、「リアルタイムのツールデータを組み合わせる」、「歴史的な対話のロジックをつなぐ」必要がある場合、「コンテキストエンジニアリング」は「検索の最適化」よりも中核的な技術的ブレークスルーとなっています。
1 RAGからコンテクストへ:自然進化の歴史的必然性
LLMのインタラクティブ機能の進化は、本質的に「外部情報の管理機能」のアップグレードです。 プロンプトのみから RAG、コンテキスト エンジニアリングまで、各ステップは前の段階の中核的な問題点に対する解決策であり、明確な歴史的必然性があります。
舞台 | キーワード | 核となる質問 | テクノロジーポートフォリオ | 典型的な欠陥 | 技術的な背景と進化の勢い |
1.0 プロンプトのみ | ゼロショット/フューショット、プロンプトテンプレート | 幻覚率が高く、知識の適時性が低く、外部情報がない | LLM + 静的プロンプトテンプレート | 外部の知識は呼び出せず、複数回の対話は簡単に切断されます | 2022 年、LLM (GPT-3.5 など) は上陸したばかりで、組み込みのパラメーター知識にしか依存できず、成熟した外部アクセス エコシステムはありません |
2.0 雑巾 | 取得後生成, ベクトルライブラリ, リフロー | 知識の欠如と幻覚の緩和 | LLM + ベクトルライブラリ(松ぼっくり/織り鳥)+ 再配置モデル(クロスエンコーダー) | 検索ノイズ、爆発的なコンテキストウィンドウ、複数回の記憶喪失、ステートレス管理 | 2023年にはベクトルデータベース技術が成熟し、LLMの「知識の有効期限」の問題は解決されるが、「継続的な相互作用における状態の継続」は考慮されていない |
3.0 コンテキスト | コンテキスト認識メモリ、動的ウィンドウ、階層型ルーティング | 会話の一貫性、状態の継続性、パーソナライズされた適応 | LLM+多層メモリ(短期/中期/長期)+圧縮/ルーティングエンジン | アーキテクチャの複雑さが増し、洗練されたプロジェクトを実装する必要があります | 2024 年には、企業の需要は「単一の Q&A」から「継続的なサービス」(顧客サービスや執事など) に移行し、モデルには「コンテキストを記憶し、ユーザーに適応し、ツールを接続する」ことが求められます |
コア進化ロジック:
1.0→2.0 は「補足知識」であり、LLM の知識の境界は検索を通じて「トレーニング期限」から「リアルタイム データ」に拡張されます。
2.0→3.0 は「補完状態」であり、コンテキスト エンジニアリングを通じて LLM の対話モードを「単一の独立したリクエスト」から「継続的なコヒーレント サービス」にアップグレードします。
コンテキストエンジニアリングの中核となるブレークスルーは、「コンテキスト」を「受動的にスプライスされたテキスト文字列」から「アクティブに管理された構造化状態」にアップグレードすることです。
リソース:
- LangChain公式ブログ「検索の進化:RAGからコンテキスト認識エージェントへ」https://www.langchain.com/blog/evolution-of-retrieval
- Pinecone テクニカル ホワイト ペーパー: RAG の制限とコンテキスト認識システムへの道のり https://www.pinecone.io/learn/rag-limitations/
2 RAGの7つの大罪:「リトリーブ+生成」だけでは不十分な理由
RAG は LLM 実装の「インフラストラクチャ」ですが、複雑なシナリオでは、「検索が最初、世代が追跡」という線形ロジックにより、検索アルゴリズムの最適化 (再現率の向上やベクトル モデルの最適化など) によって完全に解決できない多くの根本的な問題が明らかになります。
症状 | 根本原因 | 実際のビジネスケース | 業界の問題点データ |
ノイズの取得 | 意味的類似性≠事実相関:ベクトル検索は、テキスト埋め込み類似性に基づいていますが、「意味的に類似したコンテンツが現在の問題に論理的に関連している」かどうかを判断することはできません | 電子商取引のカスタマー サービスのシナリオでは、ユーザーが「自動会員更新の購読を解除する方法」を尋ねると、RAG は「会員の自動更新を有効にする方法」を取得し (2 つのセマンティクスは非常に似ていますが、操作ロジックはまったく逆です)、モデルが誤ったガイダンスを与える原因となります | Pineconeの2024 RAG Landing Reportによると、回答エラーの34%が検索ノイズによるもの |
窓の爆発 | 上位 K の検索結果は過去の会話に重ねられ、トークンの数はすぐに LLM コンテキスト ウィンドウの制限を超えます | 金融投資調査シナリオ: ユーザーとモデルが複数のラウンドで「株式評価」について話し合い、各ラウンドで 5 つの調査レポート (各 1k トークン) を取得し、3 ラウンド後に合計トークンが 15,000 に達し、GPT-3.5 (4k ウィンドウ) の上限を超え、システム OOM またはキー履歴の切り捨てが発生します | OpenAI開発者調査によると、RAG着陸プロジェクトの62%が「ウィンドウ爆発」により対話ラウンドの制限(≤5ラウンド)を余儀なくされている |
複数回の記憶喪失 | 履歴テキストのみをつなぎ合わせ、構造化メモリなし:RAGは、履歴対話を「プレーンテキスト文字列」としてプロンプトにつなぎ合わせ、重要な情報(ユーザーの好み、以前の結論など)を抽出することはできません | 政府相談のシナリオ: ユーザーが最初のラウンドで「居住許可の申請方法」を尋ねたところ、モデルが答えました。 第3ラウンドでは「どんな材料を用意する必要がありますか?」と尋ねられました。 モデルは過去の会話に関連付けることができないため、「どのようなビジネス資料を参考にしていますか?」と答えました。 ” | Alibaba Cloud のインテリジェントなカスタマーサービス調査によると、複数回の健忘症により、ユーザーの繰り返し質問率が 47% 増加し、満足度が 29% 低下しました |
年齢に悩まされたドリフト | ベクターライブラリの更新サイクル(通常は日/時間)が、リアルタイムのシーン需要(分/秒)と一致しません。 | 株式コンサルティングのシナリオ:2024年5月20日、株価が突然値底まで下落しましたが(10:00に発生)、RAGベクトルライブラリの最新データは5月19日の調査レポートであり、モデルは依然として「目標株価100元」の回答に基づいており、リアルタイム市場とは完全にかけ離れています | ブルームバーグの金融LLMアプリケーションレポートは、適時性のドリフトにより、金融セクターにおけるRAG回答の58%の「情報失敗率」につながっていると指摘した(リアルタイムシナリオ) |
ツールが混乱している | 統一されたツール結果処理メカニズムなし: RAG は "ドキュメント検索結果" のみを処理しますが、ツール (API) はさまざまな形式 (JSON/CSV/テキスト) を返し、使用可能なコンテキストに正規化することはできません | ライフ サービスのシナリオ: ユーザーが「北京明日の天気 + 私の速達の進捗状況」と尋ねると、天気 API は JSON ({"temp":25, "rain":false}) を返し、速達 API はテキスト (「速達が署名されました」) を返しますが、RAG は 2 つを統合できず、モデルは天気の質問にのみ答えます | LangChain 開発者コミュニティの調査によると、RAG+ ツール プロジェクトの 73% が追加の「ツール結果フォーマット」モジュールの開発を必要としており、開発コストが 30% 増加しています |
パーソナライゼーションの欠如 | 検索結果はすべてのユーザーに対して均一であり、ユーザーの属性(ID、好み、過去の行動など)を組み合わせることはありません | ビデオプラットフォームのカスタマーサービスシナリオ:VIPユーザーは「広告をキャンセルする方法」を尋ね、RAGは「一般ユーザーは広告をキャンセルするにはメンバーを開く必要がある」を取得しましたが、「VIPユーザーには広告がない」というパーソナライズされたルールを呼び出さず、冗長なガイダンスになりました | Tencent Cloud の C エンド LLM アプリケーション レポートによると、パーソナライゼーションの欠如により、ユーザー コンバージョン率が 22% 低下しました (パーソナライズされたコンテキスト ソリューションと比較して) |
コストが制御不能になる | 各リクエストは、「検索 + リフロー + 生成」のプロセス全体をトリガーし、キャッシュやオンデマンド呼び出しメカニズムを使用せずに | 企業の OA アシスタント シナリオ: 朝のラッシュアワー (9:00-10:00) に、1,000 人のユーザーが「年次休暇ルール」を照会し、RAG は毎回 OA ドキュメント ライブラリ (5,000+ ドキュメント) を取得するため、ベクトル ライブラリの呼び出しコストは 10 倍になり、ピーク時のピーク消費量は 8 倍になります | AWS Bedrock のコスト分析によると、最適化されていない RAG プロジェクトトークンのコストは、Context ソリューションのコストよりも 40%-60% 高いことがわかっています。 |
リソース:
- 松ぼっくり 2024 RAG 着陸レポート: https://www.pinecone.io/resources/state-of-rag-2024/
- Alibaba Cloud インテリジェントカスタマーサービステクノロジーホワイトペーパー:https://help.aliyun.com/document_detail/251245.html
- LangChainツール統合ガイド:https://python.langchain.com/docs/modules/tools/
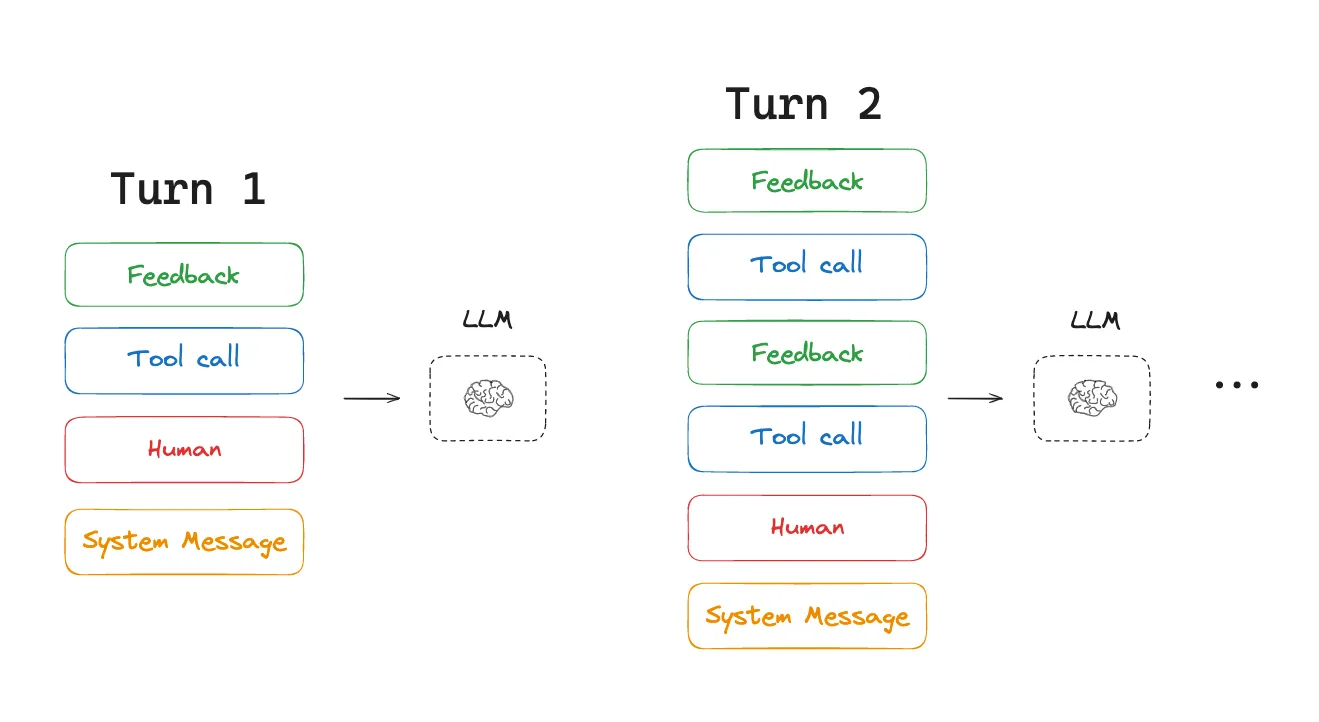
3 コンテキストエンジニアリングのトリプル哲学:レイヤリング、圧縮、ルーティング
コンテキストエンジニアリングは「RAGの代替」ではなく、RAGではカバーできない状態管理の問題を解決するための体系的な「コンテキストガバナンスロジック」です。 その核となるアイデアは 3 つの哲学として要約でき、各層は特定のテクノロジー実装パスに対応しています。
3.1 階層化:コンテキストを「元の位置に戻す」
コアアイデア: 「すべての情報が混在した管理」による非効率性や情報損失を回避するために、「適時性」と「再利用性」に応じてコンテキストをさまざまなレベルに分割します。
本質は、人間の記憶の「短期記憶-中期記憶-長期記憶」のロジックを模倣し、さまざまなライフサイクルの情報がさまざまな記憶および想起戦略に対応するようにすることです。
メモリレベル | データ型 | 生活環 | ストレージメディア | コアロール | 例 |
短期記憶 | このラウンドの対話の一時的な情報、ツール呼び出しの中間結果 | セッション中(セッション終了時に空に) | LLM KV キャッシュ、メモリ変数 | 「ユーザーの現在の質問は(『本製品』)を参照している」など、この対話の論理的な一貫性を裏付ける | ユーザーは「この携帯電話のバッテリー容量」と尋ね、短期記憶ストレージは「『この携帯電話』とは、先ほど説明したiPhone 15を指します」 |
中期 | 複数回の会話、重要な情報、一時的なユーザーのニーズ | セッションの合間(例:24時間以内、時間外清掃) | 分散キャッシュ(Redis)、軽量ベクトルライブラリ | 「ユーザーの最後の不完全なコンサルテーション」など、セッション間でのコンテキストの継続のサポート | ユーザーは昨日「居住許可の処理」を尋ね、引き続き「資料の準備ができました、次のステップは?」」、中間記憶抽出「前回処理プロセスを知らされましたが、現在「提出資料」のステップを接続する必要があります」 |
長期 | ユーザーペルソナ、長期的な好み、固定された知識(例:企業ルール) | 永続性(有効期限なし、定期的な更新) | リレーショナルデータベース(MySQL)、グラフデータベース(Neo4j)、フルベクトルライブラリ | 「ユーザーはVIPであり、独占的なサービスの提供を優先する必要がある」などのパーソナライズされた適応と長期的な知識の再利用をサポートします | ユーザーは銀行のVIP顧客であり、長期記憶には「VIPユーザーはキューをスキップし、専属アカウントマネージャー」が保存され、相談するたびにこの情報を呼び出します |
テクノロジー実装の重要なポイント:
- レベル間の「循環ルール」: 短期記憶の重要な情報 (ユーザーの明確な好みなど) は、長期記憶に自動的に同期する必要があります (たとえば、ユーザーが「私は新エネルギー株のみに焦点を当てています」、短期記憶→長期記憶)。
- 階層的優先順位: プロンプトを生成する場合、短期記憶の優先度が最も高く (このラウンドのロジックを確保するため)、長期記憶が 2 番目の優先順位 (パーソナライゼーションを確保するため)、中期記憶はオンデマンドで呼び出されます (冗長性を避けるため)。
リソース:
- コンテキストエンジニアリング公式wiki:レイヤードメモリ設計 https://github.com/davidkimai/Context-Engineering/wiki/Layered-Memory-Design
- 人類論文「Memory Systems for Long-Term Agent Interaction」https://arxiv.org/abs/2401.08500
3.2 圧縮: コンテキストを「軽量」にする
核となるアイデア: 重要な情報を失わないことを前提に、「要約、プルーニング、構造化」などの手段を通じてコンテキストのトークン消費を削減し、「ウィンドウの爆発」の問題を回避します。
圧縮の核心は「単純な切り捨て」ではなく、「セマンティックコアを保持し、冗長な情報を削除する」ことであり、圧縮されたコンテキストが LLM の論理的判断を引き続きサポートできるようにします。
一般的な圧縮戦略の比較
圧縮戦略 | 原理 | 適用可能なシナリオ | 圧縮性 | ツール/モデルの推奨 |
セマンティック要約 | LLM (GPT-4o-mini、Llama 3 など) を使用して、長いテキスト (複数ラウンドの対話、検索結果など) を要約し、コア ロジックを保持します | 複数回の履歴対話と長い文書検索結果 | 30%-50% (例: 1k トークン→500 トークン) | |
キー情報の抽出 | 構造化ストレージのルールまたはLLMに基づいて、テキストから主要なフィールド(ユーザーID、デマンドタイプ、時間、場所など)を抽出します | ユーザーのポートレート、ツール返品結果(宅配業者情報、注文状況など) | 60%-80%(例:500トークンテキスト→100トークン構造化データ) | Llama インデックス KeyExtractor:https://docs.llamaindex.ai/en/stable/module_guides/indexing/node_parsers/key_extractor/ |
冗長性プルーニング | 重複/類似情報(ユーザーの質問の繰り返し、検索結果の重複段落など)を特定して削除します。 | 複数の会話ラウンドでコンテンツと上位 K の検索結果が重複する | 20%-40% | |
階層圧縮 | 最初にテキストの 1 段落を要約し、次に要約の複数の段落を圧縮します (「要約の要約」を形成します) | 多数の検索結果(例:Top-10の研究報告)、超長時間の対話(10ラウンド以上) | 50%-70% | LangChain HierarchicalSummarizer:https://python.langchain.com/docs/modules/data_connection/document_transformers/hierarchical_summarization/ |
ケース: 電子商取引カスタマー サービスのシナリオでは、ユーザーの 5 ラウンドの会話には「注文の問い合わせ→返品申請→返金の進行状況→再注文」が含まれ、元の会話テキストは 2k トークンに達します。 重要な情報抽出 (注文番号、返品ステータスの抽出) + セマンティック サマリー (各ラウンドのコア要件の要約) を通じて、圧縮後に必要なトークンは 600 個のみで、重要な情報が失われることはありません。
リソース:
- OpenAI コンテキスト圧縮ガイド: https://platform.openai.com/docs/guides/context-compression
- Llama インデックス圧縮モジュールのドキュメント: https://docs.llamaindex.ai/en/stable/module_guides/indexing/compressors/

3.3 ルーティング: コンテキストを「コールオンデマンド」にする
核となるアイデア: 「ユーザーリクエストタイプ」と「現在のシナリオ」に基づいて最も関連性の高いコンテキストレベル/ソースを動的に選択し、「すべてのコンテキストがプロンプトに詰め込まれている」ことによる冗長性と非効率性を回避します。
ルーティングの本質は「コンテキストフィルタリング」であり、LLMが「潜在的に関連するすべての情報」ではなく、「現時点で必要な情報」のみを表示できるようにします。
ルーティング決定の中核的な側面
- リクエストタイプルーティング:質問するユーザーの意図に基づいて、対応するコンテキストソースを選択します
- 例: ユーザーが「年次休暇は何日残っていますか」(OA クエリ クラス)を尋ね→「長期記憶 (ユーザー ID) + ツール コンテキスト (OA API は結果を返す)」にルーティングされます。
- 例: ユーザーが「最後の会議の議事録はどこにありますか」(履歴会話)を尋ね→「中期記憶(会話の最後の 3 ラウンドの要約)」にルーティングされます。
- 情報の優先度ルーティング: コンテキストの重要度スコアに基づいて上位 N の情報を選択します
- スコアリングの側面: 現在のリクエストとの相関関係 (コサイン類似性)、適時性 (現在の時刻に近いほど、スコアが高い)、ユーザーの注意 (ユーザーが「重要」とマークした情報のスコアが高い)。
- 例: ユーザーが「明日の北京の天気」と尋ね→、「先週の天気検索結果(適時性スコア 0.2)」ではなく「ツールコンテキスト (リアルタイム天気 API、適時性スコア 0.9)」へのルート。
- シナリオベースのルーティング: 現在のビジネスシナリオに基づいて無関係なコンテキストをフィルタリングします
- 例: 「電子商取引ショッピング カート シナリオ」では、ユーザーは「これは返金できますか」と尋ね→「短期記憶 (現在のショッピング カート アイテム) + 長期記憶 (ユーザー メンバーシップ レベル、VIP 送料無料返品)」にルーティングされ、「OA 関連のコンテキスト」をフィルタリングします。
- 例: エンタープライズ・ファイナンスのシナリオでは、ユーザーはツール・コンテキスト (財務システム API) + 長期メモリー (ユーザー部門、払い戻し権限) への経路→払い戻しの進行状況を要求し、電子商取引注文コンテキストをフィルタします。
技術的な実装: ルーティングは通常、「ルール エンジン + LLM インテント認識」の組み合わせによって実装されます - 単純なシナリオ (「気象クエリ」など) はルールでルーティングされ、複雑なシナリオ (「あいまい要件コンサルティング」など) は LLM によるインテントの識別後にルーティングされます。
リソース:
- LangChainルーティングコンポーネントドキュメント:https://python.langchain.com/docs/modules/routing/
- 人為的コンテキストルーティング論文:https://arxiv.org/abs/2402.10618

4 メカニズムディープダイビング:ウィンドウ、圧縮、レイヤリング、ルーティング、スコアリング、メモリ
コンテキスト エンジニアリングの実装は、6 つのコア メカニズムの共同作業に依存しており、これらが組み合わさって「生成から使用までのコンテキスト」のライフサイクル管理プロセス全体を構成します。
4.1 ウィンドウバジェットアルゴリズム:コンテキストの「合計制限」を制御する
中心的な目標: LLM コンテキスト ウィンドウ制限内でコンテキストの各レベルにトークン クォータを合理的に割り当てて、「1 つのレベルが多くのトークンを占有しすぎて、他のレベルで情報損失を引き起こす」ことを防ぎます。
ウィンドウ予算配分ロジック
- 基本予算の計算:
まず、「セキュリティ冗長トークン」(LLM が回答を生成するために 1k-2k トークンを予約する) を決定し、次にコンテキストに割り当てることができる合計予算を計算します。
总上下文预算 = LLM最大窗口token数 - 安全冗余token数例: GPT-4o (32k ウィンドウ) → 合計コンテキスト バジェット = 32k - 2k = 30k トークン。
- 階層クォータの割り当て:
各レベルのトークンの割合はビジネス シナリオに応じて動的に調整され、一般的な割り当てスキームは次のとおりです (必要に応じて最適化できます)。
コンテキスト階層 | 一般割当の割合 | トークンの最大制限 | 圧縮戦略 | ルールの調整 (シナリオ) |
システム (システム プロンプト、ツール スキーマ) | 10%-15% | 固定512-1kトークン | 圧縮なし(コアルールは失われません) | 多くのツール (OA アシスタントなど) を使用するシナリオは、20% に増やすことができます |
ユーザー(ユーザーのポートレート、履歴会話) | 25%-30% | 5k トークンを動的に≤ | 重要な情報抽出 + セマンティック要約 | パーソナライズされたシーン(パーソナルバトラーなど)を35%まで増やすことができます |
世界 (RAG 検索結果、一般知識) | 30%-40% | 動的に 8k トークン≤ | 冗長な剪定 + 階層化された要約 | 知識集約型のシナリオ(投資調査など)は45%まで増やすことができます |
ツール (ツール API が結果を返す) | 15%-20% | 3k トークンを動的に≤ | 構造化抽出 (JSON→ テキスト) | 頻繁なツールコール(ロジスティクス問い合わせなど)を25%まで増やすことができる |
- 動的調整ロジック:
- レベルに情報がない場合(たとえば、ユーザーがツールを呼び出しない場合)、そのクォータは自動的に他の層(ワールド層など)に割り当てられます。
- 特定のレベルで情報が多すぎる場合 (たとえば、履歴会話の 10k トークン)、クォータ制限を超えないように「ディープ コンプレッション」(二次要約など) がトリガーされます。
リソース:
- OpenAI コンテキストウィンドウ管理ガイド: https://platform.openai.com/docs/guides/context-window
- Llama Index ウィンドウの予算最適化: https://docs.llamaindex.ai/en/stable/module_guides/indexing/window_budget/

4.2 スコアリング機能: コンテキストの「優先順位付け」
中心的な目標: 定量的なスコアリングを通じて、「現在のリクエストにとって最も価値のある」コンテキスト スライスを除外し、「無関係な情報がトークンを占有する」ことを回避します。
スコアリングモデル設計(加重合計法)
上下文切片评分 = 0.4×相关性得分 + 0.3×时效性得分 + 0.2×重要性得分 + 0.1×个性化得分各次元のスコアの計算方法:
- 相関スコア (0-1):
- コンテキストスライステキストとユーザー現在の要求テキストの間の埋め込み余弦類似性を計算します。
- ツール: Sentence-BERT (軽量)、GPT-4o 埋め込み (高精度);
- 例: ユーザーが「返品プロセス」について尋ねると、「返品ルール」スライスの相関関係は 0.9 になり、「注文プロセス」スライスは 0.3 になります。
- 適時性スコア (0-1):
- コンテキストスライス生成時間と現在の時刻の差に基づいて計算され、式: (時間単位)
时效性得分 = 1 / (1 + (当前时间 - 切片生成时间)/3600) - 例: 1 時間前に生成されたスライスは 0.9、24 時間前に生成されたスライスは 0.3、7 日前に生成されたスライスは 0.1 になります。
- 重要度スコア (0-1):
- 手動注釈または LLM 自動判断: 重要な情報 (ユーザー ID、注文番号など) は 1.0、冗長な情報 (丁寧な言葉遣いなど) は 0.2 です。
- 例: 「ユーザーは VIP メンバーです」スライスすると 1.0 になり、「ユーザーが「ありがとう」と言った」スライスで 0.2 になります。
- パーソナライズされたスコア (0-1):
- スライスと「ユーザーの長期的なポートレート」の一致度が測定されます:一致が高いほど、スコアは高くなります。
- 例: ユーザーのポートレートは「新エネルギー車愛好家」で、「新エネルギー車割引」をスライスして 0.9 を取得し、「燃料自動車割引」をスライスして 0.2 を取得します。
スコアリングアプリ:
- スクリーニング: スコアが 0.5 ≥スライスのみが保持されます (しきい値は必要に応じて調整できます)。
- 並べ替え: スコアの降順で、高得点のスライスが最初にプロンプトに追加されます。
リソース:
- 松ぼっくりの相関スコアリングメカニズム:https://www.pinecone.io/docs/score/
- LangChainコンテキストスコアリングコンポーネント:https://python.langchain.com/docs/modules/data_connection/retrievers/score_based/
4.3 メモリ更新戦略: コンテキストを「動的に反復」させる
中心的な目標: あらゆるレベルでメモリの「適時性」と「正確性」を確保し、LLM の判断に影響を与える「古い情報」や「誤った情報」を回避します。
すべてのレベルでのメモリ更新ロジック
メモリレベル | トリガーの更新 | 更新頻度 | データサニタイズルール | ストレージ・メディアの操作 |
短期記憶 | 各ラウンドの会話の後 | リアルタイム(1ラウンドにつき1回) | セッション終了直後に空 | メモリ変数のリセット |
中間記憶 | 1. 3ラウンドの対話ごとに。 2. ユーザーが明示的に「覚えておいてください」と要求します。 3. 重要な情報(注文番号など)が検出されました | セッション中3〜5ラウンドごとに1回 | タイムアウトクリーンアップ(デフォルトは24時間、設定可能) | Redis キャッシュの更新/削除 |
長期記憶 | 1. ユーザープロファイルの変更(会員レベルのアップグレードなど) 2. 修正された知識の更新 (企業規則の調整など)。 3. 毎月定期的に完全更新 | オンデマンド更新(メンバーアップグレード時など)+定期更新(月1回) | 情報の有効期限が切れた場合にのみ更新される永続的な保存(例:ルールの廃止) | MySQL/Neo4j の挿入/更新 |
主な更新メカニズム:
- 増分更新: 完全なカバレッジを回避するために、変更されたフィールドのみを更新します (たとえば、ユーザーの携帯電話番号が変更された場合は、「携帯電話番号」フィールドのみを更新し、その他のポートレート情報は保持します)。
- 競合の解決:新しい情報が古い情報と競合する場合、「信頼性の優先順位」に従って処理されます。
- 優先度: ツール API がデータを返す (信頼度が高い) > ユーザーが明示的に入力する (中) > LLM が結論を生成する (低)。
- 例: LLM はユーザーが VIP であると認識しますが、ツール API は「ユーザー メンバーシップの有効期限が切れました」を返し、API データに基づいてメモリが更新されます。
リソース:
- コンテキスト・エンジニアリング・メモリー更新のドキュメント: https://github.com/davidkimai/Context-Engineering/wiki/Memory-Update-Strategy
- LangChainメモリコンポーネント:https://python.langchain.com/docs/modules/memory/
4.4 コンテキスト処理プロセス
- アクセスを要求する: ユーザーは「注文した 12345 がまだ発送されていないのはなぜですか?」を送信します。 "、session_idを運びます(現在のセッションを識別します)。
- メモリプル: session_idによると、ContextManager は短期記憶から「このセッションで議論された注文 12345」を抽出し、長期記憶から「ユーザーは VIP メンバー (配信優先度が高い)」をプルします。
- ルーティングフィルタリング:ルーターは「注文クエリ」インテントを識別し、RAGを呼び出して「注文配送ルール」を取得し、電子商取引APIを呼び出して「注文12345のロジスティクスステータス(アウトバウンド、輸送中)」を取得し、3つの高スコアスライス(注文情報、ロジスティクスステータス、VIP配送ルール)を除外します。
- 圧縮適応: Compressor は GPT-4o 32k ウィンドウ バジェット (例: 物流ステータス JSON→「注文 12345 が出荷され、現在輸送中」) に従って 3 つのスライスを圧縮し、合計トークンは 2k 以内に制御されます。
- LLM 呼び出し: ContextManager アセンブリ プロンプト (システム: 「電子商取引カスタマー サービス、VIP ルールが最初に使用されます。ユーザー: VIP ユーザー。ワールド: 配送ルール;ツール: 物流ステータス」)、LLM が呼び出されて回答が生成されます。
- メモリ更新:「この会話(ユーザーが注文の配送について尋ね、物流状況に答える)」を中間メモリに更新し、後続のユーザーが「いつ到着するのか」を尋ねられるようにします。
5 RAGとの相乗効果:置き換えではなく「アップグレード」
コンテキスト エンジニアリングは、「RAG を排除する」のではなく、RAG を「コア駆動型」から「コンテキストのソースの 1 つ」に格下げし、「コラボレーション アーキテクチャ」を通じて RAG の固有の欠点を解決します。この 2 つの関係は、RAG が「ナレッジ プロバイダー」であり、コンテキストが「ナレッジ マネージャー」であるということです。
5.1 協調アーキテクチャ設計(コアは「RAGプラグイン」)
コンテキスト エンジンは、RAG 検索結果に直接依存して回答を生成するのではなく、RAG を「ワールド レイヤーのコンテキストのプラグイン」として使用します。 具体的な構造は次のとおりです。
- RAG の役割: 「外部知識の検索」のみを担当し、「検索結果スライス」(ソース、コンテンツ、関連性スコアを含む) を返します。
- コンテキストの役割: RAG によって返されるスライスの「二次処理」 - スコア スクリーニング (相関の低いスライスの削除)、圧縮 (適応ウィンドウ)、ルーティング (オンデマンドでプロンプトを追加する)、メモリ更新 (キー取得結果を長期記憶に保存する) が含まれます。
5.2 RAG の問題点の共同解決
RAGの問題点 | コラボレーションソリューション | 改善された結果 |
ノイズの取得 | コンテキストのルーティングスコアリングメカニズム:RAGによって返されたスライスは、「現在のリクエストとの相関」によって再スコアリングされ、0.6≥スライスのみが保持されます | 検索ノイズによるエラー率を40%削減(パインコーンテストデータ) |
窓の爆発 | コンテキスト圧縮メカニズム: RAG によって返された Top-10 の結果を最初にプルーニングし (Top-5 を保持)、次に要約します (記事ごとに 1k→300 トークン) | RAG関連のトークン消費量が60%減少 |
複数回の記憶喪失 | コンテキスト中メモリ: RAG から取得された重要な情報 ("注文出荷ルール" など) は中期間メモリに格納され、後続の会話を繰り返し取得する必要はありません | 重複検索率を75%削減し、応答遅延を30%削減 |
パーソナライゼーションの欠如 | コンテキストの長期記憶:ユーザープロファイル(VIPなど)に基づいてRAG検索結果をパーソナライズしてフィルタリングします(たとえば、VIP関連のルールのみが保持されます) | パーソナライズされた回答の精度が35%向上(Tencent Cloudテストデータ) |
5.3 協働プロセスの例(金融投資調査シナリオ)
- ユーザーは「貴州茅台の収益は2024年第1四半期にどれくらい増加しますか?」と尋ねました。 期待通りか? ”;
- コンテキスト エンジンは「必要な最新の財務データ + アナリストの期待」を識別し、RAG プラグインを呼び出して「貴州茅台 2024 年第 1 四半期財務報告書」と「アナリスト調査レポート」を取得します。
- RAG は 10 件の文書 (財務報告書 5 件、調査報告書 5 件) を返送し、相関スコアは 0.3-0.9 でした。
- ContextのRouterは3つの文書(財務報告書2件、調査レポート1件)を≥0.7のスコアで選別し、Compressorはそれを「2024Q1の収益成長率は15%、アナリストは予想12%〜14%、予想を上回った」と要約しました。
- コンテキストは、「ユーザーは機関投資家(詳細データが必要)」の長期記憶を組み合わせて、主要な財務報告データ(「収益1200億元、前年比+15%」など)を補完します。
- LLM を呼び出して回答を生成するプロンプトを組み立てます。
- 「貴州茅台2024年第1四半期収益15%」は長期記憶に保存され、その後のユーザーは「茅台の成長率が持続しているか」を尋ねる際に直接再利用できます。
リソース:
- ラマインデックスRAGとメモリの相乗効果:https://docs.llamaindex.ai/en/stable/use_cases/rag_memory/
- Pinecone RAGプラグインガイド:https://www.pinecone.io/docs/rag-plugins/
6 迅速なパラダイムシフト:「1回限りのQ&A」から「継続的な会話」へ
コンテキスト エンジニアリングの人気により、プロンプト デザインのパラダイムは、「単一のリクエストに対するスタンドアロン プロンプト」から「継続的な対話のためのステートフル プロンプト」へと根本的な変化が起こりました。
6.1 2つのパラダイムの核心的な違い
次元 | 1 回限りの Q&A パラダイム (RAG 時代) | 継続的な対話パラダイム(コンテクスト時代) |
プロンプト構造 | 修正テンプレート: System + 用户当前提问 + RAG检索结果 | 動的構造: System + 压缩后的历史上下文 + 当前提问 + 按需加载的World/Tool切片 |
情報源 | 「現在のリクエスト + RAG」のみに依存し、履歴ステータスはありません | フルステートを含む「多層メモリ+リアルタイムツール+RAG」に頼る |
設計の目的 | 単一の応答の精度を確保 | 複数の会話ラウンドにわたる一貫性、パーソナライゼーション、適時性を確保 |
代表的な例 | システム: 「提供されたドキュメントに基づいて、ユーザーの質問に回答します。」 <br> ユーザー: 「GPT-4o の紹介です。」 <br>RAG: 「GPT-4o は 2024 年にリリースされる OpenAI のモデルです...」 | システム:「電子商取引の顧客サービス、ユーザー会員権の使用が優先されます。 <br> 歴史的背景: 「ユーザーは VIP です。命令 12345 を参照してください。」 <br>は事前に「なぜまだ出荷されていないのですか?」と尋ねました。 <br>Tool slice: "注文 12345 は倉庫から出荷され、輸送中です。 ” |
6.2 連続対話パラダイムの設計原則
- 状態の明示性: 主要な状態 (ユーザー ID、注文番号、履歴の結論など) をテキストに非表示にするのではなく、「構造化フィールド」としてプロンプトに埋め込みます。
- 例:
[用户属性:VIP会员,订单号:12345] [历史结论:订单已出库]
- 冗長性を最小限に抑える: 無関係な会話が繰り返されるのを避けるために、「現在の判断に影響を与える」履歴情報のみが保持されます。
- 反例:10ラウンド前に「挨拶」をつなぎ合わせる。
- 例:「現在の注文に関連する会話の要約を2回」のみ保持します。
- ツールの結果の構造化: ツールから返された JSON/CSV を「自然言語 + キー フィールド」に変換して、LLM の理解コストを削減します。
- 例: ツールは、「注文 12345 (ステータス: 出荷済み、出荷時間: 2024-05-20)」に変換された→を返します。
{"order_id":12345,"status":"shipped","time":"2024-05-20"}
6.3 パラダイム移行の技術サポート
- ContextManager の動的アセンブリ機能: 現在のリクエストに応じてプロンプト構造を自動的に調整し、固定テンプレートを手動で記述する必要がなくなります。
- 圧縮エンジンのセマンティック保持: 履歴コンテキストが圧縮された後にクリティカル状態が失われないようにします。
- メモリ層の状態継続能力: ユーザー属性や過去の結論などのコア情報をラウンド間で保持します。
リソース:
- OpenAI Chat Completions API ドキュメント (マルチターン会話デザイン): https://platform.openai.com/docs/guides/chat
7 シナリオベースの着陸設計スキーム
コンテキスト エンジニアリングの価値は、特定のビジネス シナリオの実装を通じて反映される必要があり、以下は「需要の問題点、アーキテクチャ設計、プロセス ステップ、および主要な構成」をカバーする 3 つのコア シナリオの詳細な設計計画です。
7.1 シナリオ 1: インテリジェントな顧客サービス (電子商取引分野)
7.1.1 コア要件と問題点
- 要件: ユーザーは、注文、返品、アフターサービスなどの質問に対して、過去の対話、注文データ、会員の権利と組み合わせて、一貫性のあるパーソナライズされた回答を提供する必要があります。
- 問題点: 複数回の健忘症 (ユーザーが繰り返し質問する)、パーソナライゼーションの欠如 (VIP ユーザーは独占的なサービスを享受できない)、適時性の低さ (注文ステータスがリアルタイムで更新されない)。
7.1.2 アーキテクチャ設計
コンテキスト階層 | データソース | コア分野/コンテンツ | 生活環 | 圧縮戦略 |
短期記憶 | この会話の対話 | 現在の問い合わせ注文番号、ユーザーの一時的な要件(例:「迅速な処理」) | セッション内 | キー情報の抽出 (注文番号のみ、需要タイプ保持) |
中間記憶 | 過去7日間の会話のまとめ | 未解決の問題 (例: 「最後に返された問い合わせが完了していません」)、ユーザー設定 (例: 「オフライン返品を優先する」) | 7日間 | セマンティック要約 (会話の各ラウンド→最大 100 語の要約) |
長期記憶 | ユーザーポートレートシステム | 会員レベル(VIP/通常)、過去のアフターセールス記録(例:「過去3か月間返品なし」)、配送先住所 | 永 | 構造化ストレージ (フィールド レベルの更新、圧縮なし) |
ワールド レイヤー | EコマースFAQライブラリとヘルプセンター | 返品ルール、配送適時性、会員権益 | オンデマンド更新(ルール変更時) | 冗長なプルーニング (手元の問題に関連するルール フラグメントのみを保持します) |
ツールレイヤー | 注文API、物流API、アフターセールスAPI | 受注状況、物流進捗、アフター申込進捗 | リアルタイム (要求呼び出しごと) | 構造化変換 (JSON→自然言語 + キー フィールド) |
7.1.3 主なプロセス(例として「VIPユーザー照会注文返品」を取り上げます)
- アクセスを要求する: ユーザーは「注文 67890 を返品できますか?」を送信します。 私はVIPです」とsession_idを運びます。
- メモリプル:
- 短期記憶: pull "'注文 67890' はこのセッションで言及されています";
- 長期記憶: 「ユーザーは VIP メンバーです (返品送料無料、理由なし 7 日間)」をプルします。
- ルーティングフィルタリング:
- 「返品相談」の意図を特定し、注文 API を呼び出して「注文 67890 (署名済み、購入時刻の 3 日前)」を取得します。
- RAGに電話して「VIP返品ルール」を取得し、「VIPユーザーは署名後7日以内であれば理由なく商品を返品でき、送料無料」を返品します。
- スコアが 0.8 ≥スライスを除外します: 注文ステータス、VIP 返品ルール。
- 圧縮適応:
- 注文 API によって返される JSON (200 トークン) を「注文 67890 (署名済み、3 日間購入)」 (50 トークン) に圧縮します。
- RAG ルール (500 トークン) を「VIP ユーザー 7 日間理由なし、送料無料」(80 トークン) に圧縮します。
- LLM 呼び出し:
- プロンプトを組み立てる:;
System(电商客服,优先VIP规则)+ User(VIP用户,订单67890)+ Tool(订单状态)+ World(VIP退货规则) - LLM は回答を生成しました: 「注文 67890 (3 日間署名済み) は VIP 返品条件を満たし、7 日間の理由なし返品をサポートし、返品運賃はプラットフォームが負担します。[返品申請] をクリックして操作します。 ”;
- メモリ更新:「ユーザー問い合わせ命令 67890 返却、条件を満たす」を中間メモリに更新し、ユーザーが「申請方法」を尋ねたときに直接再利用します。
7.1.4 主な構成
- ウィンドウ予算: GPT-4o (32k ウィンドウ)→合計予算 28k、システム層 512 トークン、ユーザー層 8k、ワールド層 12k、ツール層 5k。
- スコアリングしきい値: 0.5 (スコアが 0.5 ≥スライスのみが保持されます)。
- TTL 構成: 7 日間の中期記憶、短期記憶セッションの終了時にクリアされます。
リソース:
- Alibaba Cloud インテリジェントカスタマーサービスコンテキスト設計スキーム:https://help.aliyun.com/document_detail/251245.html
- JDカスタマーサービステクノロジーブログ:https://tech.jd.com/article/612345
7.2 シナリオ2:B側OAアシスタント(エンタープライズドメイン)
7.2.1 コア要件と問題点
- 要件: 従業員は、年次休暇、給与明細、承認の進捗状況について問い合わせ、休暇/払い戻し申請書を提出し、企業の OA データと従業員の ID 権限に基づいて、コンプライアンスに準拠した正確なサービスを提供します。
- 問題点: ツールが混乱している (OA システムが多数あり、API 形式が異なる)、権限管理が厳格 (部門によって従業員が権限が異なる)、情報の機密性 (給与などの機密データを暗号化する必要がある) が重要です。
7.2.2 アーキテクチャ設計
コンテキスト階層 | データソース | コア分野/コンテンツ | 生活環 | 圧縮戦略 | 安全上のご注意 |
短期記憶 | この会話の対話 | 現在の申請の承認票番号、従業員の一時的な要件(例:「迅速な承認」) | セッション内 | 重要な情報の抽出 | メモリ暗号化ストレージ |
中間記憶 | 過去 30 日間の承認レコード | 不完全な承認(例:「償還が進行中」)、過去の申請結果 | 30日間 | セマンティックサマリー+構造化フィールド | Redis 暗号化ストレージ |
長期記憶 | 企業人事制度、権限制度 | 従業員の部署、役職、年次休暇の額、給与水準、承認権限 | 永 | 構造化ストレージ (フィールド・レベル) | データベース暗号化 + 権限制御 |
ワールド レイヤー | エンタープライズ OA ルール ベースおよびシステム ドキュメント | 年次休暇のルール、払い戻し基準、および承認プロセス | 必要に応じて更新(システム変更の場合) | ルールフラグメントの抽出 | 文書権限制御 |
ツールレイヤー | 年次休暇API、給与計算API、承認API | 年次有給休暇の残り日数、給与明細、承認の進捗状況 | リアルタイム通話 | JSON →構造化テキスト | API 呼び出しは暗号化されます |
7.2.3 主なプロセス(例として「従業員問い合わせ年次休暇の残り日数」を取り上げます)
- アクセスを要求する: 従業員が「年次休暇は何日残っていますか?」を送信します。 "、従業員 ID (関連する権限) を使用します。
- メモリプル:
- 長期記憶: 「従業員 A (製品部門、2020 年入社、年次休暇量 15 日、5 日使用済み)」をプルします。
- 中期記憶: 「従業員 A は昨年 3 日間の年次休暇を取得しなかったが、今年に繰り越すことができる」をプルします。
- ルーティングフィルタリング:
- 「年次休暇クエリ」の意図を特定し、年次休暇 API を呼び出して「2024 年の年次休暇 5 日、繰り越し 3 日」を取得します。
- RAGに電話して「企業年次休暇規則」を取得し、「繰り越し年次休暇は翌年3月までに使用する必要があります」を返します。
- スコアが 0.8 ≥スライスを除外します: 年次休暇 API データ、繰越ルール。
- 圧縮適応:
- API によって返される JSON (300 トークン) を「2024 年の 5 日間、3 日間にわたって繰り越される」(60 トークン) に圧縮します。
- RAG ルール (400 トークン) を「繰り越し年次休暇は 2025 年 3 月までに使用する必要がある」(70 トークン) に圧縮します。
- LLM 呼び出し:
- プロンプトを組み立てる:;
System(OA助理,严格按权限返回数据,敏感信息脱敏)+ User(员工A,产品部,2020入职)+ Tool(年假数据)+ World(结转规则) - LLM は「こんにちは! 2024年の年次休暇枠は15日で、5日が使用され、残りの10日(昨年から繰り越された3日を含む)です。 ご注意:繰り越された3日間は2025年3月までに使用する必要があり、有効期限を過ぎると失効します。 ”;
- メモリ更新:中期記憶に「社員Aが2024年の残りの10日間の休暇について問い合わせる」を更新し、後続の利用者が「年次休暇の申請方法」を尋ねた際に再利用します。
7.2.4 主な構成
- ウィンドウ予算:Claude 3 Opus(100kウィンドウ)→合計予算95k、システムレイヤー1k(権限ルールを含む)、ユーザーレイヤー15k、ワールドレイヤー20k、ツールレイヤー10k。
- スコアリングのしきい値: 0.6 (OA シーンには高い精度が必要なため、しきい値を上げます)。
- セキュリティ構成:すべての機密データ(給与、IDカード)が鈍感化されて表示され、API呼び出しには従業員ID認証が必要です。
リソース:
- DingTalk OAアシスタント技術ドキュメント:https://open.dingtalk.com/document/orgapp/oa-assistant-design
- エンタープライズ WeChat 開発者プラットフォーム: https://developer.work.weixin.qq.com/document/path/90373
7.3 シナリオ3:Cエンドパーソナルバトラー(生活サービス分野)
7.3.1 コアのニーズと問題点
- 要件:ユーザーは、電子商取引の注文、物流、請求書、ショッピングカートを管理し、パーソナライズされた推奨事項(「頻繁に購入される牛乳の補充」など)を取得し、マルチプラットフォームデータ(淘宝、JD.com、美団)を組み合わせてワンストップサービスを提供する必要があります。
- 問題点: データの分散 (独立したマルチプラットフォーム アカウント)、弱いパーソナライゼーション (推奨事項がユーザーの好みと一致しない)、およびリアルタイム パフォーマンスの低下 (物流ステータスがリアルタイムで同期されない)。
7.3.2 アーキテクチャ設計
コンテキスト階層 | データソース | コア分野/コンテンツ | 生活環 | 圧縮戦略 |
短期記憶 | この会話の対話 | 現在の注文/物流追跡番号、一時的な需要(例:「受領のリマインダー」) | セッション内 | 重要な情報の抽出 |
中間記憶 | 過去 14 日間の注文/ロジスティクス レコード | 保留中の注文、保留中の請求書、最近のショッピングの好み(例:「牛乳の購入」) | 14日間 | セマンティック要約+キーワード抽出 |
長期記憶 | マルチプラットフォームユーザーポートレート(タオバオ/JD.com) | 買い物の好み(例:「低脂肪牛乳を好む」)、配送先住所、支払い習慣(例:「WeChat Payの優先」) | 永 | 構造化ストレージ + 設定ラベル |
ワールド レイヤー | ECプラットフォームの商品ライブラリ、販促情報 | 商品詳細、プロモーション(「618完全割引」など)、物流ルール | リアルタイム更新(プロモーション変更時) | 主要な製品情報(名前、価格、プロモーション)の抽出 |
ツールレイヤー | ECAPI、物流API、課金API | 注文状況、物流進捗、請求金額、カート品目 | リアルタイム通話 | JSON →キーフィールドを持つ自然言語 |
7.3.3 主要なプロセス (「ユーザー問い合わせタオバオ注文物流」を例に挙げます)
- アクセスをリクエストする: ユーザーは「タオバオで買った牛乳はどこにありますか?」を送信します。 」、個人の執事アカウント(タオバオアカウントに関連付けられている)を持参してください。
- メモリプル:
- 長期記憶: 「ユーザーは『低脂肪牛乳』を好みます。一般的に使用される配送先住所は『北京市朝陽区XXコミュニティ』です」をプルします。
- 中期記憶: 「ユーザーは 3 日前にタオバオで『低脂肪牛乳のブランド』を購入し、注文番号 78901」をプルします。
- ルーティングフィルタリング:
- 「物流クエリ」の意図を特定し、淘宝物流APIを呼び出して「注文78901(物流注文番号YT12345、現在朝陽区で配送中、1時間以内に配送予定)」を取得します。
- RAGに電話して「物流配送規則」を取得し、「朝陽区配送時間9:00-18:00」を返します。
- スコアが 0.8 ≥スライスを除外します: ロジスティクス API データ、配送ルール。
- 圧縮適応:
- API によって返された JSON (400 トークン) を「注文 78901 (牛乳)、物流YT12345、朝陽区で配送、1 時間以内に到着予定」(80 トークン) に圧縮します。
- RAG ルール (300 トークン) を「朝陽区配達時間 9:00-18:00」(50 トークン) に圧縮します。
- LLM 呼び出し:
- プロンプトを組み立てる:;
System(个人管家,结合用户偏好推荐)+ User(偏好低脂牛奶,地址朝阳)+ Tool(物流数据)+ World(派送规则) - LLMは、「3日前に購入した『低脂肪牛乳のブランド』(注文78901)、現在の物流追跡番号YT12345は朝陽区で配送されており、1時間以内に配達される予定です(朝陽区の配送時間9:00-18:00)」という回答を生成しました。 よく買う牛乳は現在在庫がありますが、注文する際に通知する必要がありますか? ”;
- メモリの更新: 注文 78901 のロジスティクス状況 (輸送中) を中期メモリに更新し、"ユーザーは再入荷する必要がある場合があります" のプリファレンス ラベルを長期メモリに更新します。
7.3.4 主な構成
- ウィンドウ予算: GPT-4o (32k ウィンドウ)→ 合計予算 28k、システム層 512 トークン、ユーザー層 10k、ワールド層 8k、ツール層 8k。
- スコアリングしきい値: 0.5;
- TTL 構成: 14 日間の中期記憶、短期記憶セッションの終了時に空になります。
- パーソナライズされた構成: 長期記憶は、ユーザー設定ラベルを 7 日ごとに更新します。
リソース:
- 美団パーソナルバトラーシナリオプラン:https://tech.meituan.com/2024/03/15/personal-butler-design.html
- Taobao Open Platform APIドキュメント:https://open.taobao.com/doc.htm?docId=101612
8つの一般的な神話とベストプラクティス
コンテキストエンジニアリングを実装する過程で、「コンテキストガバナンスロジック」の理解が不十分であるため、結果が悪くなりがちです。 ここでは、6つの一般的な誤解とそれに対応するベストプラクティスを紹介します。
8.1 よくある誤解
- 誤解 1: コンテキスト圧縮を LLM に過度に依存している
- 問題: すべてのコンテキスト スライスは大規模なモデル (GPT-4 など) で圧縮されるため、コストが高くなります (圧縮段階ではトークン消費が 40% を占めます)。
- ケース: あるプロジェクトは GPT-4 を使用してすべての歴史的対話を圧縮し、月額費用は 100,000 万元を超え、予想をはるかに上回っています。
- 誤解 2: メモリ レベルの混乱
- 問題: 「短期的な一時的な情報」(この対話の一時的なニーズなど)を長期記憶に保存し、長期記憶の冗長性が生じます。 または「長期ユーザー属性」(メンバーシップレベルなど)は短期メモリに保存され、セッション終了後に失われます。
- ケース: あるカスタマーサービスプロジェクトでは、ユーザーの「今回は迅速な処理」という一時的なリクエストを長期記憶に保存し、その後のすべての会話が「迅速処理」に優先されるため、リソースが無駄になります。
- 誤解 3: ルーティング ルールは単純すぎる
- 問題: 「キーワードマッチング」ルーティングのみは、あいまいな要件 (ユーザーが「これを取得する方法」を尋ねるなど) を処理できません。
- 例: ユーザーが「なぜ私の払い戻しがうまくいかないのか」と尋ねると、キーワード「払い戻し」が「OA 払い戻し API」にルーティングされますが、「My」をユーザー ID に関連付ける必要があります」と返され、「払い戻し番号を入力してください」と返されます。
- 誤解 4: コンテクストの適時性を無視する
- 問題: TTL (存続時間) が設定されておらず、古い情報 (期限切れのプロモーションなど) が引き続き呼び出されます。
- ケース:ある電子商取引プロジェクトは、「618プロモーション」のコンテキストスライスをクリーンアップせず、7月にも「618フルディスカウント」を推奨し、ユーザーの苦情を引き起こしました。
- 誤解 5: 安全管理の欠如
- 問題: 機密性の高いコンテキスト (給与計算、ID カードなど) は、暗号化または権限によってフィルタリングされません。
- ケース:企業のOAプロジェクトが権限によって制御されておらず、一般の従業員が他の部門の給与データを照会できるため、データ漏洩の原因となります。
- 誤解 6: 状況に応じた品質監視は行われていない
- 問題: コンテキストの「スコアリング分布」、「圧縮率」、「冗長性」が監視されないため、低品質のコンテキスト (スコアリング < 0.3) がプロンプトに入力され、LLM の応答に影響します。
- ケース: スコアが監視されていないため、相関の低い RAG 結果が大量にプロジェクトのプロンプトに入力され、LLM 回答のエラー率が 25% 増加します。
8.2 ベストプラクティス
- 階層圧縮戦略
- 軽量の情報 (ツールによって返される短いデータなど) は、ルール (JSON →テキストなど) で圧縮されます。
- 中程度の情報量 (3 ラウンドの会話など) は、小さなモデル (GPT-4o-mini、Llama 3 など) で圧縮されます。
- 大量の情報 (10 ラウンドの会話、長い文書など) は、大規模なモデル (GPT-4o など) で圧縮されます。
- 効果:圧縮コストを50%〜70%削減します。
- メモリレベルを分割する基準を明確にする
- 「メモリ階層属性表」を策定して、さまざまな種類の情報のストレージレベルを明確にします。
- テクニカルサポート: エラーの保存を防ぐために、ContextManager に「階層的検証ロジック」を追加します。
情報の種類 | ストレージ層 | TTL |
ユーザー メンバーシップ レベル | 長期記憶 | 永 |
このセッションは一時的な必要性です | 短期記憶 | セッション内 |
過去 30 日間の承認レコード | 中間記憶 | 30日間 |
- ルール + LLM ハイブリッド ルーティング
- 単純なシナリオ (「天気クエリ」や「注文クエリ + 明確な追跡番号」など) は、ルール (キーワード + フィールド マッチング) でルーティングされます。
- 複雑なシナリオ (「あいまいな要件」や「マルチインテントの混合」など) の場合は、LLM インテントを使用して事後ルートを特定します (たとえば、GPT-4o-mini を呼び出して、「ユーザーが『これを行う方法』を尋ねる」は『払い戻し申請』を参照している」ことを識別します)。
- 効果:配線精度が95%以上に向上します。
- 定期的なクリーンアップによる動的 TTL
- メッセージタイプ別に動的TTLを設定します。
- リアルタイムデータ(ロジスティクス、株価):TTL = 10分。
- プロモーション情報: TTL = イベントの終了時刻。
- ユーザーの一時的な要件: TTL=セッションの終了。
- 定期的なクリーニング: 冗長性を避けるために、期限切れの中短期記憶スライスを毎日早朝にクリーンアップします。
- フルリンクのセキュリティ制御
- 送信セキュリティ: API 呼び出しは HTTPS を使用し、機密データは暗号化されて送信されます。
- ストレージセキュリティ:長期記憶(データベース)暗号化、短期記憶(メモリ)脱感作。
- 権限制御: ユーザーの役割に基づいてコンテキストをフィルタリングします (たとえば、一般の従業員は自分の給与データのみを表示できます)。
- 監査ログ: すべてのコンテキストでプル/更新/使用操作を記録し、トレーサビリティを容易にします。
- コンテキスト品質監視メトリック
- コアモニタリング指標:
- アラームメカニズム:インジケーターがしきい値を超えると(平均スコア<0.5など)、アラームがトリガーされ、自動的にダウングレードされます(例:手動レビューが追加されます)。
インデックス | 意味 | 閾 |
スライス平均評価 | プロンプトのスライススコアの平均を入力します | ≥0.6 |
圧縮性 | 圧縮後のトークン数/圧縮前のトークン数 | ≤50% |
冗長率 | 反復数/スライス合計数 | ≤5% |
リソース:
- コンテキストエンジニアリングのベストプラクティスドキュメント: https://github.com/davidkimai/Context-Engineering/wiki/Best-Practices
- Alibaba Cloud データセキュリティガイド: https://help.aliyun.com/document_detail/107463.html
9 参考文献
9.1 公式ドキュメントと技術ホワイトペーパー
- コンテキストエンジニアリング公式ウィキ
- コアコンテンツ: 階層メモリ設計、メモリ更新戦略、ベストプラクティスケース。
- LangChain公式ドキュメント(コンテキスト関連)
- 《エージェントのためのコンテキストエンジニアリング》:https://www.langchain.com/blog/context-engineering-for-agents
- 《メモリコンポーネント》:https://python.langchain.com/docs/modules/memory/
- コアコンテンツ: LangChain のコンテキスト管理コンポーネント、RAG とコンテキストの相乗効果スキーム。
- OpenAI のコンテキスト ウィンドウ管理ガイド
- コアコンテンツ:コンテキストウィンドウの割り当て、圧縮戦略、マルチラウンドの対話デザイン。
- 松ぼっくり 2024 RAG 着陸レポート
- コアコンテンツ:RAGの問題点分析、コンテキストアウェアシステムの進化の方向性。
9.2 品質技術のブログとコラム
- Anthropic テクニカル ブログ: Memory Systems for Long-Term Agent Interaction
- コアコンテンツ:長期記憶システムの設計、コンテキストルーティングアルゴリズム。
- 特徴:Anthropic Claudeの実践経験と組み合わせて、理論と実践の組み合わせ。
- 美団技術チーム:「パーソナルバトラーのコンテキストガバナンス実践」
- コアコンテンツ: C エンド シナリオのコンテキスト階層化とパーソナライズされた適応スキーム。
- 特徴:事業着陸に近い国内大工場の実例。
- DingTalkオープンプラットフォーム:「OAアシスタントのためのコンテキストセキュリティ設計」
- コアコンテンツ: B 側シナリオにおけるコンテキスト権限制御と機密データ保護。
9.3 学術論文・研究報告
- 《会話型エージェントのためのコンテキスト認識言語モデル》(2024)
- 著者: Anthropic Team;
- コアコンテンツ:コンテキスト認識モデルのアーキテクチャ設計、ルーティングアルゴリズムの数学的原理。
- 《大規模言語モデルのためのメモリ効率の高いコンテキスト圧縮》(2024)
- 著者: スタンフォード AI ラボ。
- コアコンテンツ: 効率的なコンテキスト圧縮アルゴリズム、トークンの保存とセマンティック保持のバランス。
- 2024 年のコンテキスト エンジニアリングの現状 (Gartner レポート)
- コアコンテンツ:コンテキストエンジニアリングの業界アプリケーション状況と将来のトレンド予測。
- 著者:正直
- リンク:https://blog.hehouhui.cn/archives/context-engineering-complete-guide-llm-rag-evolution-practice-scenarios
- 陳述:この記事はCC BY-NC-SA 4.0の下でライセンスされていますので、転載の出典を明記してください。